「なんかAIっぽい」を直せる人は、何が違うのか
AI に画像やスライドを作らせて、見た瞬間に「なんか違う」と思う。でも何が違うのかを言えなくて、そのまま採用してしまう。この記事は、ファンスタメンバーからもらった「AI の成果物を採点して、失敗をためて、改善につなげる仕組みを作りたい。いつ動かせばいい?」という質問への答えです。答えの芯は、仕組みの話ではなく「自分の目と言葉」の話でした。
- 目で見る
- →言葉にする
- →採点基準にする
- →毎回チェックする
- →たまったらスキルを直す
まず3行で
- AI の成果物が良いか悪いかは、自分の目で見た瞬間に決まる。ここは AI に代わってもらえない。
- 直せない本当の原因は「失敗の種類が分からない」ことではなく、「見た違和感を言葉にできない」こと。
- だから AI をアートディレクターの位置に置いて、毎回「何をどう作ったか」を言葉にさせ、自分は決めるだけにする。採点や改善の仕組みは、その後ろに付ける。
今回はニュースの解説ではなく、STΛCK が自分の制作の現場でやっていることの整理です。サムネ、スライド、画像。全部この形で回しています。仕組みの名前は途中で出てきますが、名前より順番のほうが大事なので、順番だけ持ち帰ってもらえれば十分です。
きっかけの質問
ファンスタメンバーから、こんな質問をもらいました。要約するとこの二つです。
二つは別の話に見えますが、答えは同じ形をしています。どちらも「仕組みが動いていること」と「仕組みが効いていること」を分けて、効いているかどうかを自分の目で確かめるところから始まります。まずは全体像から。
評価は一本の鎖でできている
成果物の評価を「採点する仕組み」として一個の箱で考えると、行き詰まります。実際には五つの輪がつながった鎖で、材料は左から右へ流れます。
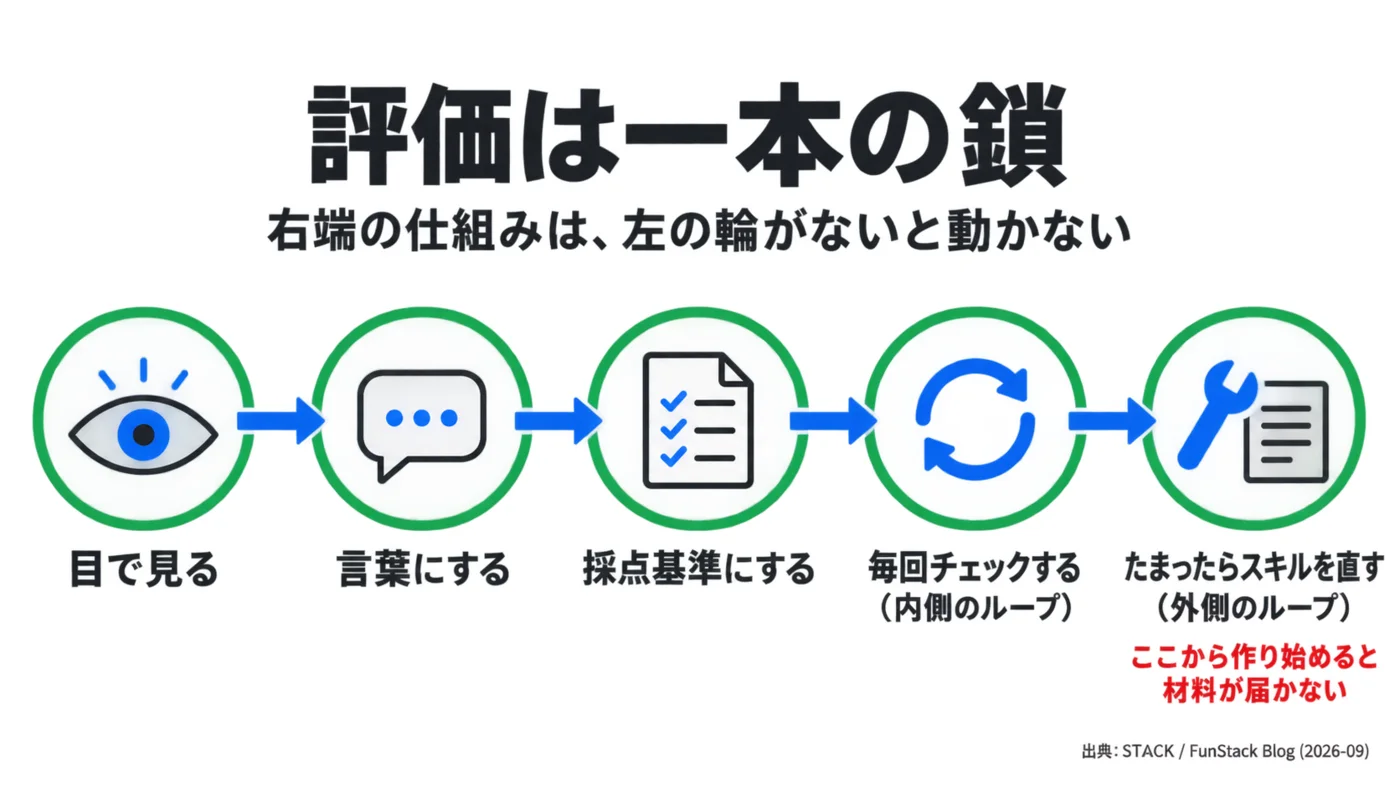
一つめの輪は目で見る。二つめは見た違和感を言葉にする。三つめはその言葉を採点基準にする。四つめは制作のたびにその基準で毎回チェックする(この記事では「内側のループ」と呼びます)。五つめは、チェックの記録がたまったらスキルを直す(「外側のループ」)。
評価の本質は、目で見て、言葉にすること
クリエイティブは目で見るもの
画像も動画もスライドも、良いか悪いか、好きか嫌いかは、見た瞬間に自分の中で決まっています。だから自分の評価軸に寄せたいなら、自分が必ず目で見て判断する工程は省けません。採点を AI に任せて自分は数字だけを見る形にした瞬間、それは AI の評価軸に寄っていくだけで、自分の作るもののクオリティは上がりません。ログを自動でとる仕組みを作るとしても、それは自分が見て判断したあとの話です。
壁:「なんか違う」から先が言えない
そのうえで壁になるのが、見た違和感をうまく言葉にして伝えられない、あるいは、なんと言えばよくなるのかを知らない、ということです。「色味がなんか変」「AI っぽい」「安っぽい」までは誰でも言えます。でもそれは感想であって指示ではないので、次の生成は変わりません。ほとんどの人はここで止まります。
本職のデザイナーが強いのはまさにここです。見た違和感をそのまま指示の言葉に変換できます。「余白を詰める」「彩度を落とす」「視線の抜けを作る」というように、何を言えばどう変わるかを体で知っている。つまり差は感性というより言語化の差で、その言語化の差は実践知(経験からくる、体で覚えた知識)があるかどうかに依存しています。どれだけの語彙と経験を持っているかで、同じ違和感でも伝えられるかどうかが全く変わります。
逆転:AI をアートディレクターの位置に置く
では本職でない人は諦めるしかないのか。STΛCK の答えは、考え方を逆にすればいい、です。自分がデザイナーの言葉を覚えてから指示を出すのではなく、AI のほうをアートディレクターの位置に置いて、毎回、そのデザインで使った技術や意図を言語化させます。
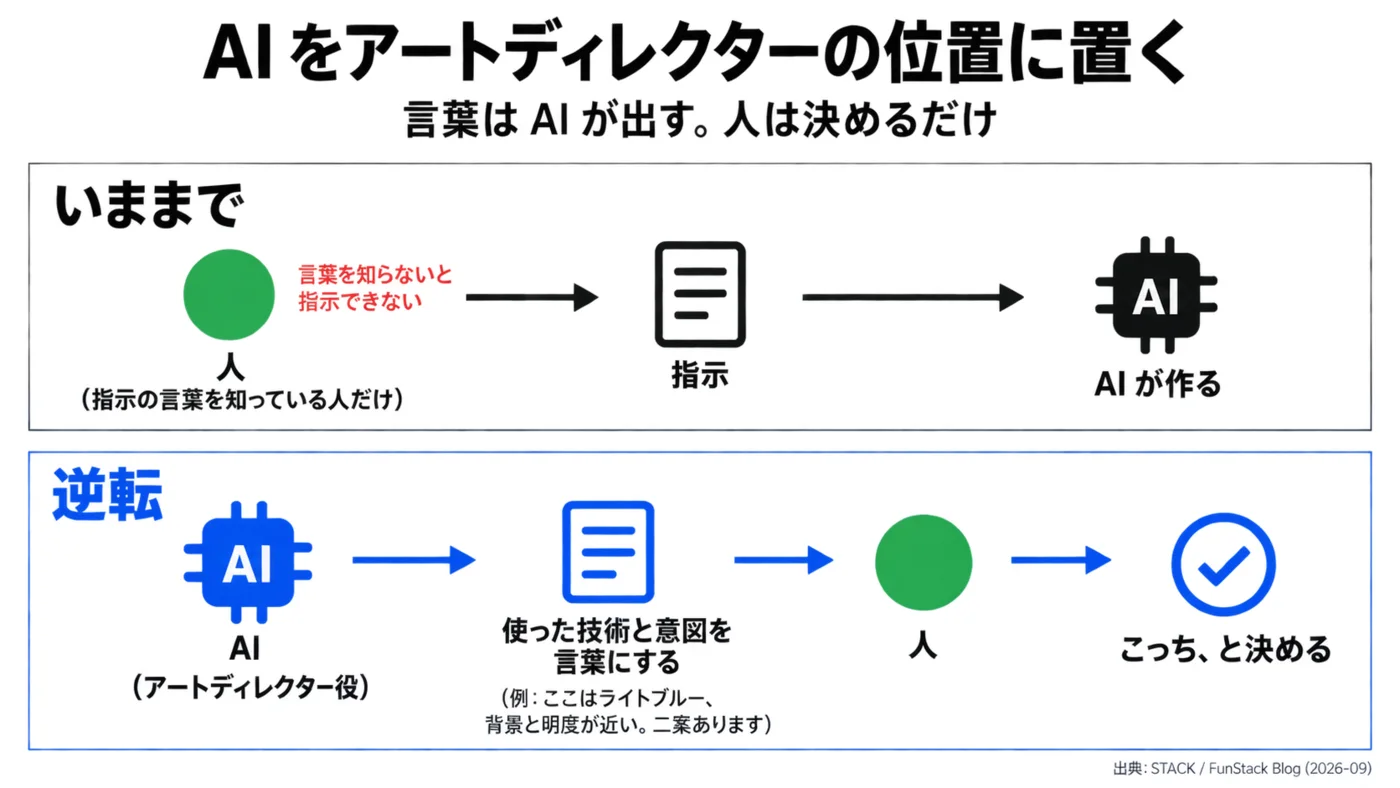
たとえば「色味がなんか変」と言ったとします。すると向こうが、ここに使っているのはライトブルーで、背景のグレーと明度が近いから沈んで見えているはずです。明度差をつけて分離させるか、彩度を上げて前に出すかの二つがあって、根拠はこうですが、どちらにしますか、と返してきます。こちらはそれに対して「こっち」と決めるだけです。
こうしておくと、三つのことが起きます。まず、知らなかった言葉が会話の中で自然に増えていきます。次に、リクエストを投げると向こうが質問と提案で返してくるので、自分の仕事は意思決定だけになります。そしてその意思決定の積み重ねが、そのまま「言葉のついた失敗ログ」になります。ただ却下したという記録ではなく、何に対してどういう理由で却下したかが、AI が言語化した言葉つきで残る。この言葉が、鎖の右側の輪に流れていく材料です。
感想の裏には、必ず具体がある
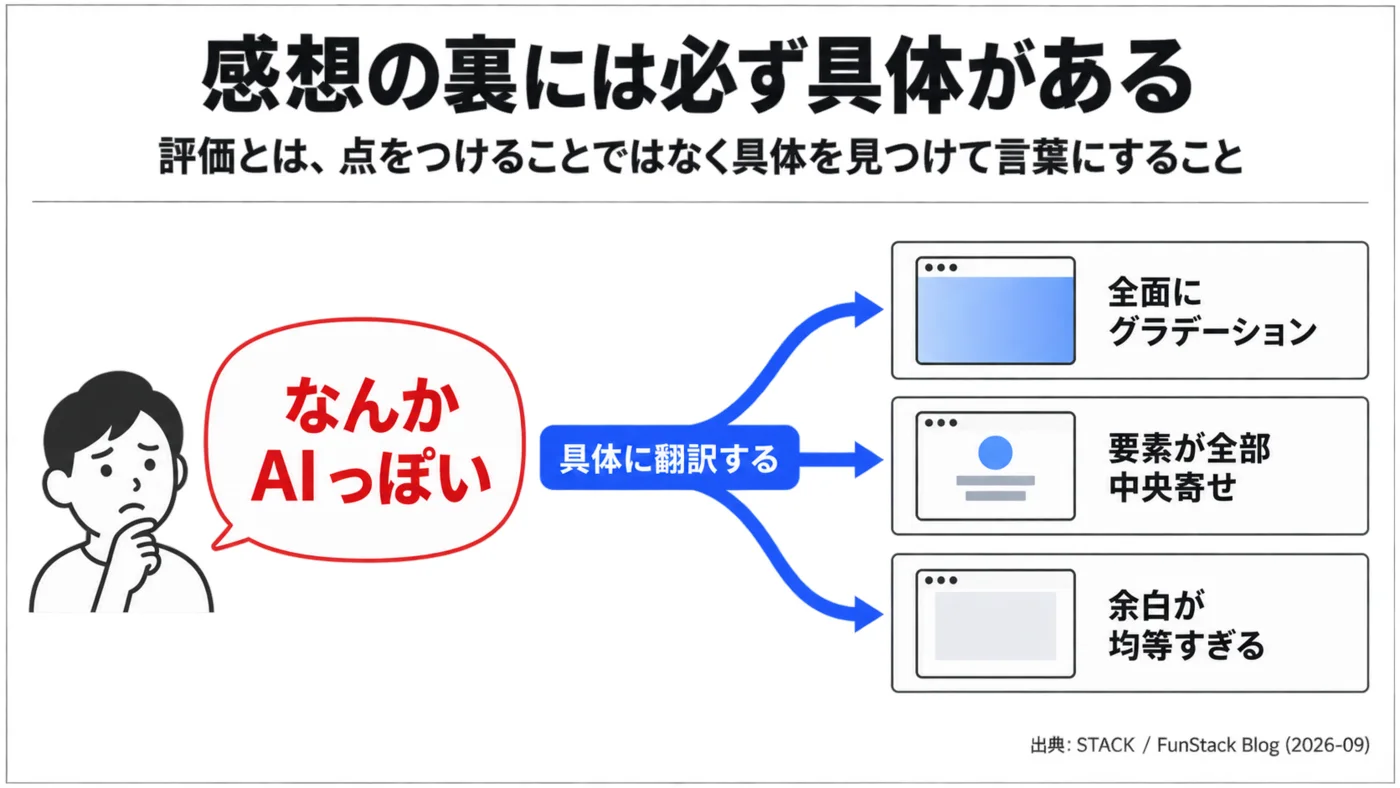
言いたいことを一つにまとめると、感想の裏には必ず具体がある、ということです。「AI っぽい」の裏には、全面にグラデーションが敷いてある、要素が全部中央に寄っている、余白が均等すぎる、書体が一種類しかない、といった具体が必ずあります。評価するというのは、点数をつけることではなく、その具体を見つけて言葉にすることです。
だから STΛCK の考えでは、評価軸をつくるというのは、自分の考えを言語化して、自分の中の「良い」や「好き」を相手に伝えられるようにすることです。採点の仕組みはその結果としてあとから付いてくるもので、先に作るものではありません。
内側のループ:採点基準を書いて、毎回チェックする
採点基準は書く。書いたら答え合わせをする
「ちゃんと動く」「いい感じ」は採点できませんが、書き下せば採点できます。ここまでで出てきた「具体の言葉」を並べたものが採点基準(ルーブリック)です。
ただし、書いただけの基準は信用しないと決めています。答え合わせをします。自分がすでに「良い」「悪い」と判定したスライドを 10 本用意して、その基準を持たせた採点役に見せ、何本が自分の判定と一致するかを見る。STΛCK は基準を 4 回書き直して、いまの版で 10 本中 7 本が合うところまで来ました。合わないうちは、自分の目ではなく基準のほうを疑います。
毎回のチェックは「別の記憶」で
実際の作業で言うと、サムネを作らせた同じチャットで、そのまま「これ採点して」と頼む場面のことです。そうすると作った本人が自分の作品を採点するので、さっき自分で選んだ理由をなぞって高めの点をつけます。
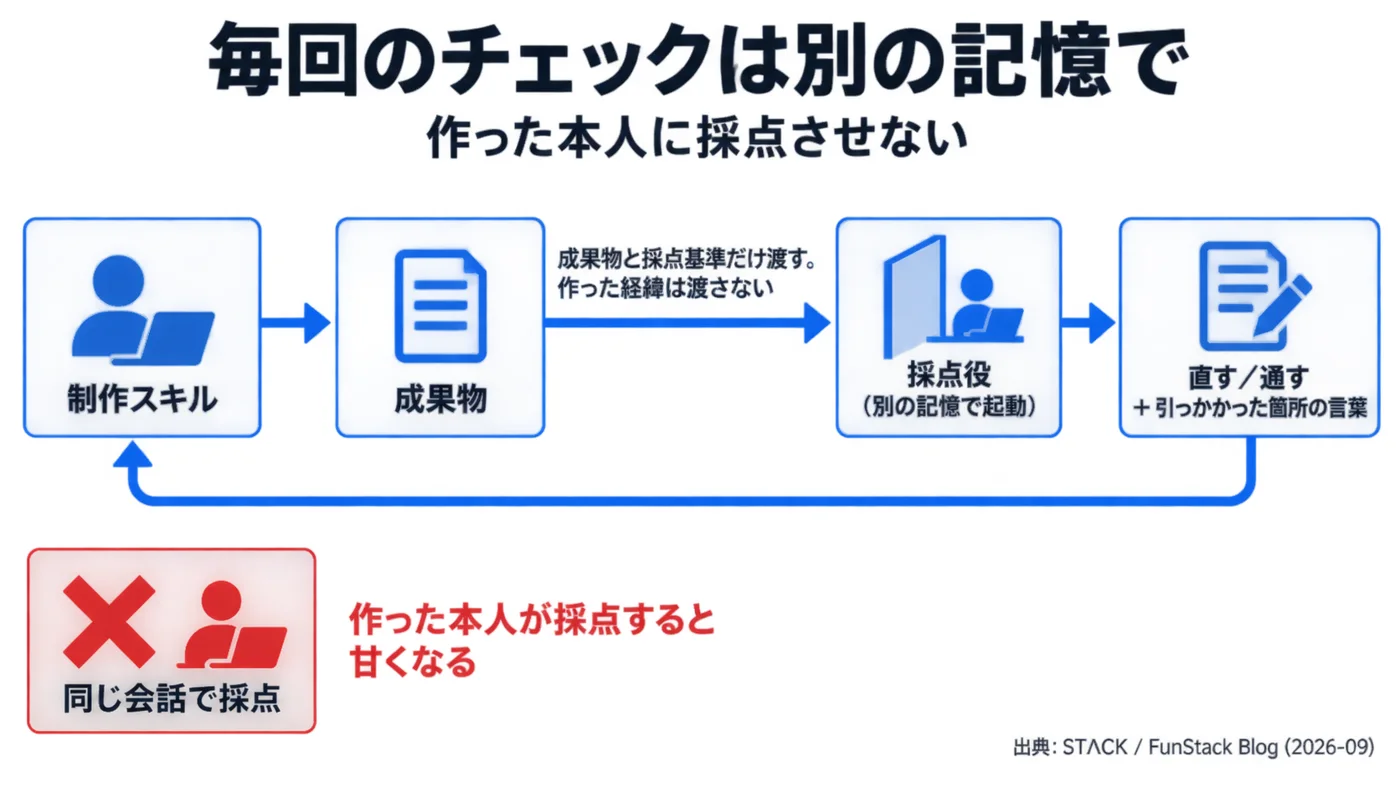
STΛCK はそこで、採点用のスキルを制作スキルとは別に一本用意しておいて、制作スキルが画像を出し終わった最後の手順で、その採点スキルを新しい記憶で起動させるようにしています。渡すのは、できあがった画像のファイルと、採点基準を書いたファイルの二つだけで、どう作ったかの会話は渡しません。採点役は初めてその画像を見る人として、点数と引っかかった箇所を返してきて、制作側はそれを読んで直します。人が手でやることは何もなく、制作スキルの最後に採点スキルを呼ぶ一行があるだけです。
外側のループ:たまったらスキルを直す
ここでやっと、質問 1 の「採点して改善の方向を出すスキルをいつ動かすか」に答えられます。答えは、失敗したときでも、定期でもなく、記録が何件かたまったときです。
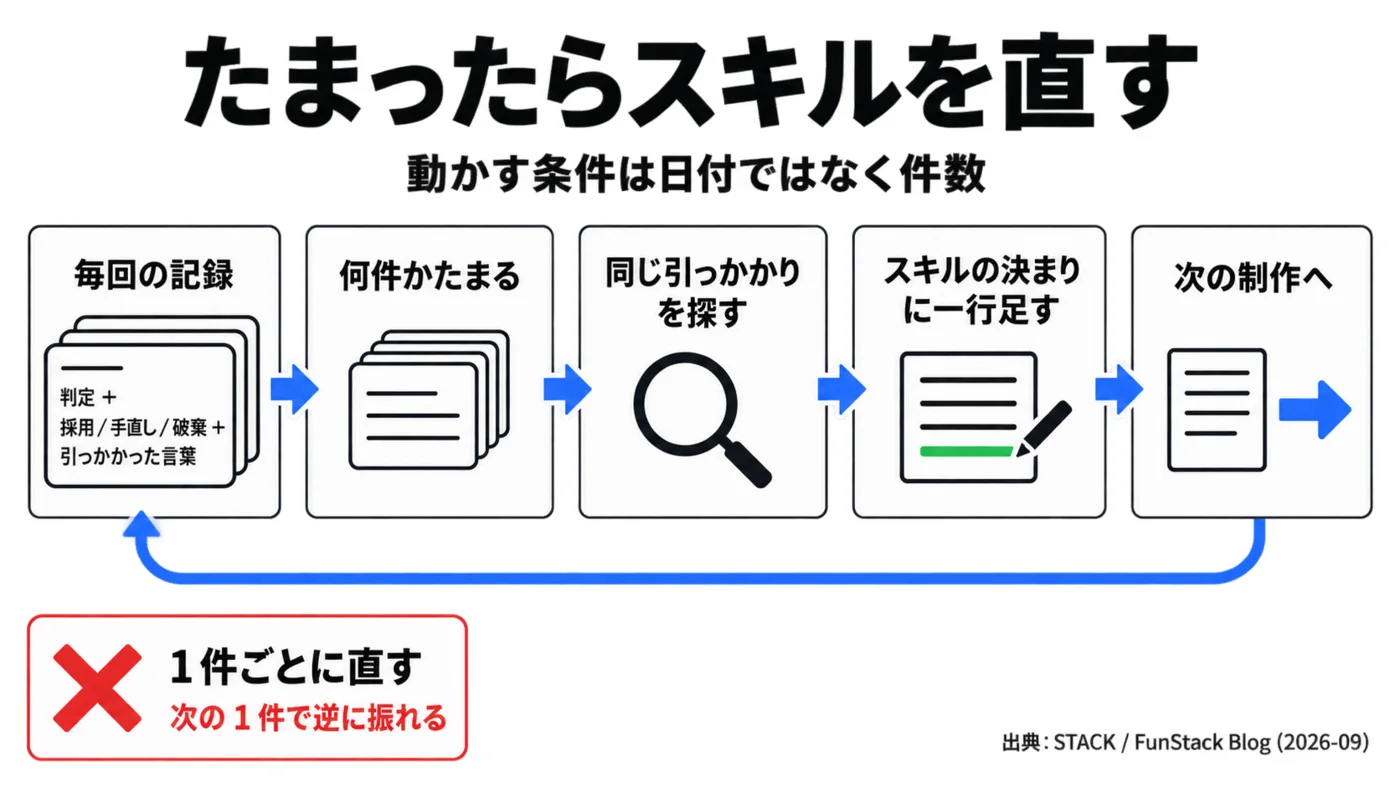
内側のループが毎回残す「直す/通す」の判定と、自分が最後にどうしたか(採用した、手直しして使った、捨てた)を、毎回セットで記録しておきます。それが何件かたまった時点で、同じ引っかかりが繰り返し出ていないかを読ませて、スキルのどこに何を足すかを提案させる。これが外側のループです。
1 件ごとに直さないのは、次の 1 件で逆に振れるからです。「毎週見直す」とカレンダーで決めないのは、記録のたまり方と噛み合わないからです。そして材料になるのは点数ではなく、内側のループが残した「引っかかった箇所の言葉」です。ここで、感想の裏の具体がちゃんと言葉になっているかどうかが、そのまま効いてきます。
STΛCK の実物:道具二つと決まり二つ
STΛCK はこれをスキル一本でやっているわけではなく、道具と決まりの組み合わせで動かしています。
案を並べて選ぶ画面
AI が出した数案をブラウザに並べて、クリックで一つ選び、一言添えると、選んだ結果と理由がその場で残る小さな道具です。
台帳に一行書くスクリプト
選んだ結果と一言を、その場で台帳ファイルに一行書き込む小さな Python スクリプト。
案を選ばせる場面では必ずその画面を通す
全スキルに読ませているルールファイル(AI が毎回読む決まりごとの文章)に、この一行が書いてあります。
記録を残さずに終えようとしたら、一回だけ差し戻す
作業の終わりに自動で走るチェック(Hook)が、記録がないまま終わろうとした AI を一回止めます。「結果はまだ分からない」なら、そう書いて終えてよい。推測で埋めさせません。
採点そのものより、選ぶ行為の中に記録を埋め込んで、忘れたら止まる形にしておくほうが、続けやすかったです。記録する仕組みを別に作ると、あとで書こうとして必ず忘れます。
監視スキルは、効いているのか
質問 2 は、STΛCK 自身が一度そのまま踏んだ話です。
STΛCK の手元には、作業中に「本当は使うべきスキル」を使い忘れたら注意を出す、監視の仕組みがあります。入れてしばらくは、注意が出ているのを見て、効いていると思っていました。ところがある日、その注意のあとのログを 10 本ほど読み返してみると、注意が出たあとで実際にそのスキルが使われた回は、ほとんどありませんでした。文章を書くソフトの、誤字の下に出る赤い波線と同じです。波線は出ている。でも、直さずに送っている。
ここで分かったのは、監視が「動いていること」と「効いていること」は別で、しかもその差は数字を眺めていても見えない、ということでした。反応した回数はログに出るので、そこだけ見れば立派に働いているように見えます。効いているかどうかは、注意が出たあとに何が起きたかを、自分の目でログを追って初めて分かります。
だから今は、確かめる順番を決めています。まず、監視がそもそも反応した回数を残す。次に、反応したうち本当に使い忘れだったものがいくつあるかを、ログを読んで数える。それから、監視を切った状態で同じ作業を数本やってみて、使い忘れが本当は何回起きるのかを知る。これが分母になります。最後に、反応のあとに実際にそのスキルが使われたかを見る。この四つめで、いちばん差が出ました。
注意を出すだけでは無視される、と分かった時点で、監視は「注意」から「記録がなければ先に進めない」形に変えました。波線ではなく、送信前に止まる確認画面です。
つまり質問 2 の答えも、鎖の一つめの輪と同じです。自分の目で見る。見る相手が、成果物からログに変わっただけです。監視スキルを持っていなくても、AI に任せているチェック(校正、確認リスト、リマインド)は全部同じで、「動いている」で安心しないで、そのあと自分がどう動いたかを一度見に行く。それだけです。
AI と働く個人は、何を考えればいいか
ここからは質問の外の話です。FunStack のように「AI を使って前に進みたい人」が、この鎖から何を持ち帰るべきか。
1. 見る工程を手放さない
AI に作らせる量が増えるほど、一枚一枚を見るのが面倒になります。でも見なくなった瞬間に、自分の評価軸は育つのをやめて、AI の平均的な評価軸に置き換わります。
2. 「なんか違う」と言った直後に、翻訳させる
違和感は感想のままだと消えます。言葉になれば残ります。翻訳する役は自分でなくていい。AI に、いま何をどう使ったのかを言わせ、自分の違和感がどの要素の話なのかを聞き返させます。
3. 記録は「仕組み」より「置き場」
ログをとる仕組みを別に作ると、あとで書こうとして忘れます。選ぶ、決める、という行為の中に記録を埋め込むと、忘れようがありません。
4. 引き算:いま「やらない」と決めておくこと
- 1 件の失敗でスキルを直さない。たまってから。
- AI に「なぜ却下したか」を推測で埋めさせない。自分が言わなかった理由は空欄のまま残す。
- 点数だけで判断しない。点数の横に「引っかかった箇所の言葉」がないログは、材料にならない。
- 監視を増やす前に、いまある監視が効いているかをログ 10 本で確かめる。
ひとことで
読んだ感想は、作業ラボに投稿していただけるとありがたいです。「ここが分からなかった」「自分はこうしている」のひとことで十分です。
ことば帳
- スキル
- AI にやらせる仕事の手順書。「サムネを作る」「スライドを組む」のように、仕事ごとに一本ある。
- 評価軸(ルーブリック)
- 良い・悪いを判断する物差しを文章にしたもの。「余白が均等すぎない」「書体は二種類まで」のように、具体で書く。
- 内側のループ
- 一回の制作の中で毎回回るチェック。今回の成果物を直すためのもの。
- 外側のループ
- 何回か制作したあとに回る見直し。スキルそのものを直すためのもの。
- 別の記憶で起動する
- 会話の記憶(コンテキスト)を切り離して、まっさらな別の AI を立ち上げること。Claude Code では context: fork。作った本人に採点させないための箱。
- 決まり(rules と hooks)
- rules は AI が毎回読む決まりごとの文章。hooks は作業の節目に自動で走るチェック。「必ずこうする」を文章で頼むのが rules、「守らなければ止める」を機械でやるのが hooks。
- アートディレクター
- デザインの方向を決め、なぜそうするかを言葉で説明する役。この記事では AI にその役を担わせる。
- 実践知
- 経験からくる、体で覚えた知識。本職が「何を言えばどう変わるか」を知っているのはこれ。
- 分母
- 「本当は何回起きていたか」の数。監視が何回反応したかだけでは成績が出せない。
- 案を並べて選ぶ画面
- AI が出した数案を並べて、クリックで一つ選び、理由を添えられる画面。STΛCK は選択の記録をここで取っている。
この記事のもとになった記録
きっかけ: ファンスタメンバーからの質問と、STΛCK の回答(2026年9月15日)
STΛCK の制作現場の実測: 採点基準の答え合わせ(4 版目で 10 本中 7 本一致、2026年9月時点)
関連する前回の記事: AIのアクセルをゆるめよう と、AI会社の社長が言い出した話 の「3. 人の価値が残る場所は『判断・評価・責任』」
※ 図解の中の例(ライトブルーと背景の明度、全面グラデーションなど)は説明のための一例で、特定の作品を指していません。